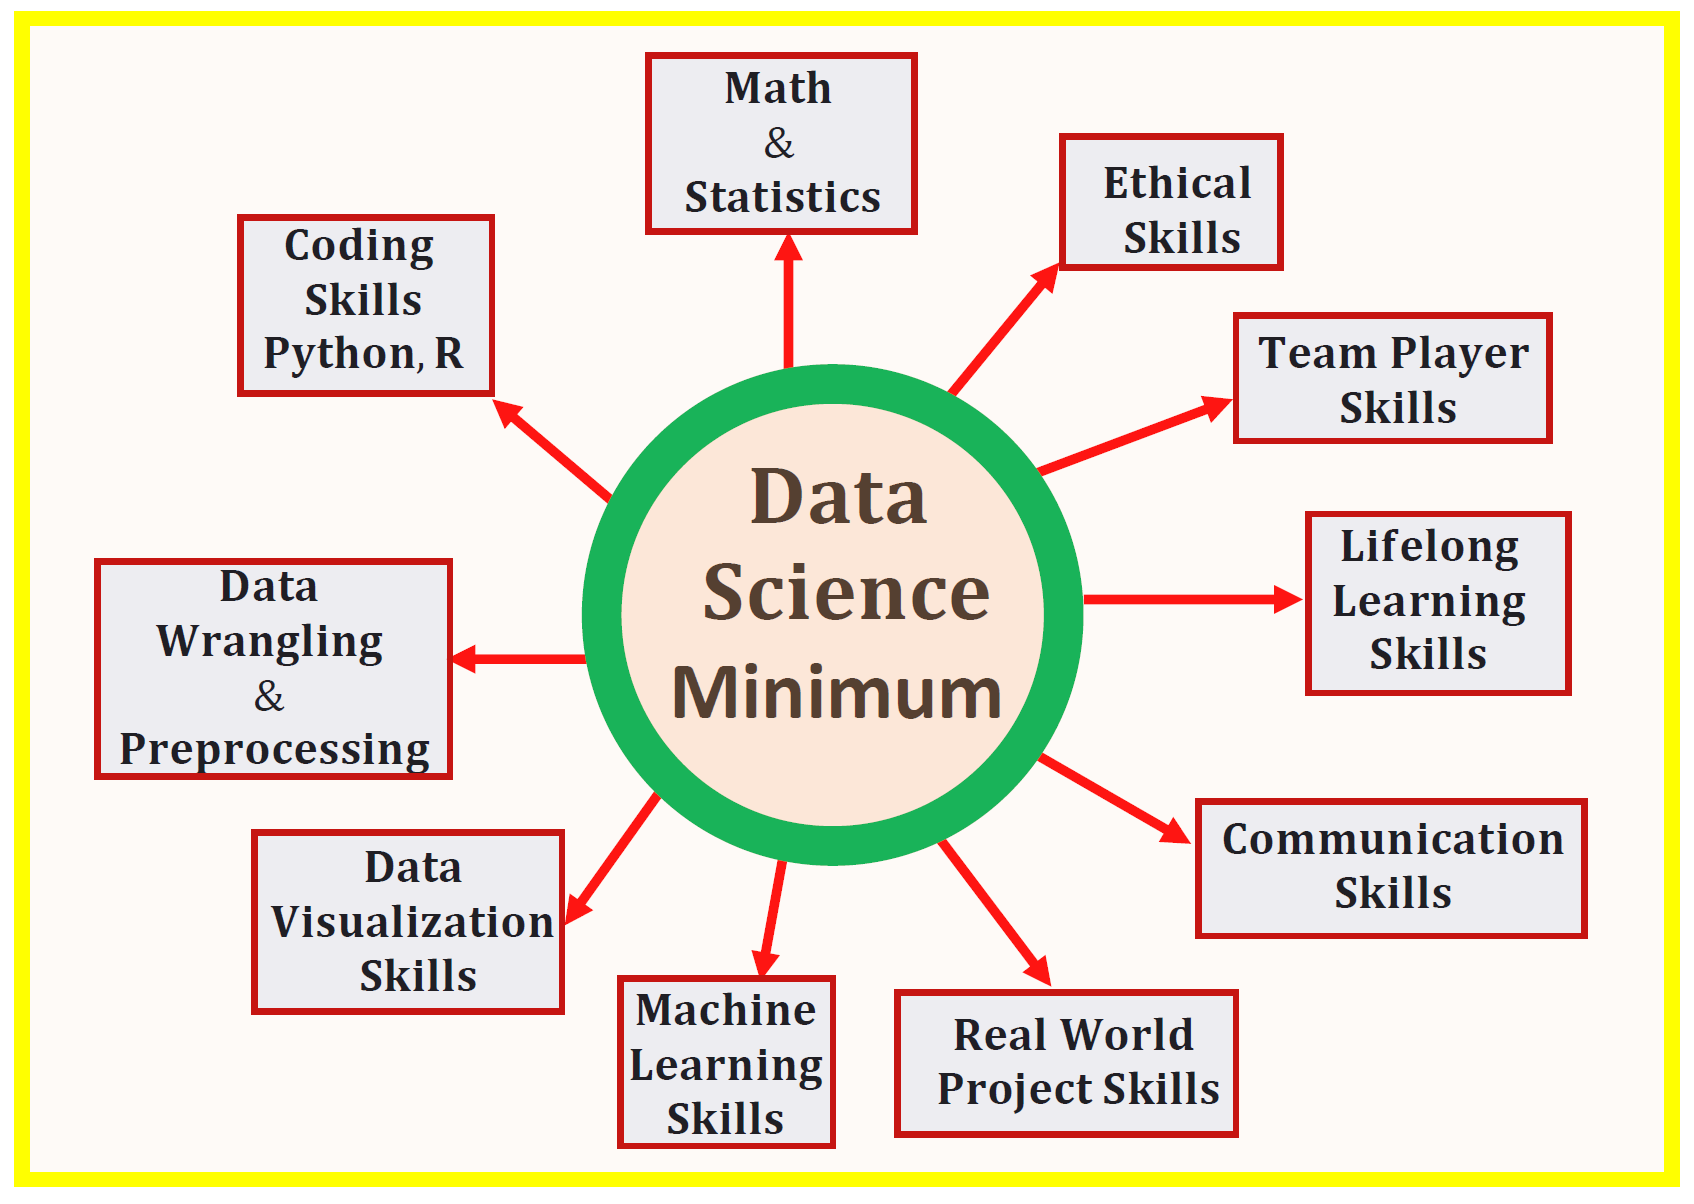
O que precisamos para entrar em Data Science?
- Linguagem de consulta como SQL
- Linguagem de programação como R/Python
- Ferramenta de visualização como PowerBI/Qliksense/Qlikview/Tableau etc.
- Estatísticas básicas para aprendizado de máquina
- Algoritmos de aprendizado de máquina (certifique-se de experimentar casos de uso no domínio em que deseja se especializar, vendas, finanças, RH, operações etc. Os casos de uso serão diferentes para todos)
- Prática e implementação
a) Linguagem de consulta
Tipos de linguagens de consulta que você pode aprender: SQL é de longe o melhor do mercado e não vai a lugar nenhum.
Mais uma linguagem de consulta que você pode aprender é elasticsearch. É muito usado hoje em dia. Aprendi em um curso da Udemy. A diferença entre SQL e elasticsearch é que em elasticsearch, você tem um dataframe onde nem todas as linhas têm os mesmos valores de coluna. Por ex. um carro de banco de dados. Digamos que para alguns carros temos apenas informações sobre o nome do modelo, preço e cor. Para alguns, podemos ter cor, modelo, preço, número de modelos até a data, empresa controladora etc., para outro tipo de carro podemos ter informações sobre apenas modelo e nome etc. No SQL isso é capturado colocando valores NAN nos campos estão faltando. No elasticsearch, não existe o conceito de NAN.
Fontes de aprendizado: Você pode aprender no W3Schools/Tutorialspoint ou em qualquer lugar, já que dificilmente levará uma semana para aprender SQL. Se você não tiver acesso a bancos de dados para praticar, poderá carregar qualquer arquivo csv como banco de dados e praticar.
Elasticsearch/Kibana pode ser aprendida através dos mesmos sites. Além disso, você pode fazer um curso da Udemy no mesmo, pois isso é mais difícil de aprender em comparação com o SQL.
Ambiente: Caso você esteja aprendendo SQL, você pode instalar o MySQL/PostGRESQL e iniciar a prática. Para elasticsearch você pode instalar o Kibana e praticar.
Por que a linguagem de consulta é importante para a ciência de dados?
Temos enormes conjuntos de dados em ciência de dados que têm milhões de linhas e milhões de colunas. Para análise, você não precisa de todos os dados. Precisamos extrair os dados relevantes usando uma linguagem de consulta e, em seguida, prosseguir com a análise.
Big Data: Você também pode aprender linguagens ou técnicas de big data como Scala e Hadoop/MapReduce etc. No entanto, isso é bom para a maioria dos trabalhos de DS e não é obrigatório. É mais como uma cereja no topo do bolo. Big data faz parte da engenharia de dados e geralmente envolve codificação, ao contrário da ciência de dados, que é uma mistura de estatística, matemática, codificação e conhecimento de domínio. O big data deve ser aprendido depois que você estiver completo com a ciência de dados.
b) Linguagem de programação
Idiomas em voga: Existem 2 idiomas principais: R e python. R é uma linguagem projetada por estatísticos e matemáticos. Python é uma linguagem de codificadores. Ambos são bons. No entanto, hoje em dia o Python está mais em voga devido ao seu grande ecossistema de suporte do mundo da programação, melhor escalabilidade e melhor integração com APIs e outros códigos para o produto completo.
Fonte de aprendizado: aprendi Python via Coursera. O nome do curso era “Python para ciência de dados”. Você também pode aprender via tutorialspoint e W3schools. Mais do que o curso, aprendi através de projetos maiores e menores que deveríamos fazer como parte do nosso certificado.
Aprendi R pela Udemy. Curso Avançado em R para Ciência de Dados. É bom aprender um idioma em profundidade e ter uma visão geral de outro idioma junto com ele. Isso porque em uma equipe você trabalhará com muitos cientistas de dados. Alguns ficarão confortáveis com R e outros com python.
Ambiente : Notebooks Anaconda Navigator, Pycharm, Spyder ou Jupyter.
Um ambiente é um lugar onde você basicamente codifica e implementa seus códigos.
Meu ambiente favorito pessoal são os notebooks Jupyter. Os notebooks Jupyter permitem que você digite R/Python/HTML etc., para que você possa usar as melhores bibliotecas ou técnicas de uma linguagem específica e usá-la no Jupyter. Além disso, se duas pessoas estiverem usando idiomas diferentes, você poderá colaborar facilmente usando os notebooks Jupyter.
Resolução de consultas: Stackoverflow e Stackexchange são ótimos lugares para fazer consultas sobre problemas de idioma. As pessoas geralmente respondem dentro de 5 minutos a 24 horas.
c) Ferramentas de visualização
Ferramentas que você pode aprender: Tableau/PowerBI/Qliksense/Qlikview são as ferramentas mais comuns. PowerBI e Tableau são os mais usados.
O PowerBI é quase como uma versão avançada do Excel e muito fácil de aprender. O único problema com o Excel é que ele trava e fica lento com dados enormes. Também não há muitas opções disponíveis para visualizações incríveis. Tudo isso é possível no PowerBI. Outra coisa boa é que o PowerBI é gratuito. Para o Tableau, você pode baixar uma versão de avaliação de 30 dias, mas no caso do PowerBI, você pode usá-lo pelo tempo que quiser (a maioria dos recursos está disponível na versão gratuita do PowerBI). O PowerBI/Qliksense/Qlikview não é compatível com a Apple, pois são produtos baseados em Windows.
Fontes de aprendizado: aprendi PowerBI por meio da Udemy. Eu selecionei o curso com base nas classificações. Qualquer curso com uma classificação acima de 4,3 é legal. Aprendi o Tableau pelo site do Tableau.
d) Estatísticas para Ciência de Dados:
Termos básicos que você deve conhecer: desvio padrão, média, mediana, moda, assimetria, teste de hipótese, teorema do limite central, população versus amostra, pontuação z, intervalo de confiança, valor p, significância estatística, valor crítico, teste de proporção, bicaudal , unicaudal, princípio de Pareto, teste qui-quadrado, teste z, teste t, distribuição normal, distribuição gaussiana etc.
Fontes de aprendizado: Curso da Udemy sobre Estatística para Ciência de Dados de Kirill Eremko, Introdução ao Aprendizado Estatístico em R ou qualquer livro básico de estatísticas.
e) Algoritmos de aprendizado de máquina:
Tipos de Algos mais utilizados: XGBoost, RandomForest, Deep Learning, Redes Neurais, Séries Temporais, Árvores de Decisão, Clustering e Algos de Classificação.
Fontes de aprendizado: o curso de Kirill Eremko na Udemy para aprendizado de máquina é incrível.
O livro Otxts é ótimo para algoritmos de visualização de ML. É uma fonte gratuita e um dos melhores recursos disponíveis online. https://otexts.com/fpp2/graphics-exercises.html
Introdução ao aprendizado estatístico em R é bom para noções básicas de estatísticas e aplicativos em ML
Como decidir quais algoritmos implementar:
Primeiro, conheça o caso de uso do seu problema. O que você quer fazer? Sua saída é uma variável contínua? (tomando valores 1,3,10 etc. basicamente qualquer valor) ou é um tipo de decisão binária ou você quer bater nas pessoas e tomar algumas decisões para um monte de gente?
Por ex. para um projeto, tive que trabalhar na análise de risco de crédito em finanças. Você tem que decidir se uma pessoa será capaz de pagar um empréstimo ou não. Portanto, é uma decisão binária. Nesse caso, você precisa de um algoritmo de classificação porque deseja classificar uma pessoa como inadimplente ou não inadimplente. Então eu uso Regressão Logística (usado quando a saída é binária sim/não etc), XGBoost ou árvores de decisão. Você pode basicamente usar qualquer algoritmo de classificação. Outros algoritmos de classificação que podem ser usados aqui são SVN, Naive Bayes etc. (você pode pesquisar algoritmos de classificação no Google para obter a lista completa).
Se em um projeto, eu preciso prever o valor de uma ação ou casa, então pode levar qualquer valor a partir de Rs.10 a Rs.1.000.000 ou mais, etc. (uma variável contínua). Aqui vou usar regressão. A regressão pode ser de vários tipos, linear simples, linear múltipla, polinomial, SVR etc. O tipo certo de técnica de regressão pode ser encontrado verificando o erro r quadrado (a distância entre os valores previstos e os reais).
Da mesma forma, se eu precisar descobrir os segmentos de destino, precisarei usar o algoritmo de clustering. K significa e agrupamento hierárquico são exemplos de algoritmos de agrupamento.
Então, primeiro aprenda sobre os algoritmos (pelo menos um algoritmo de classificação, um algoritmo de agrupamento, um algoritmo de regressão para começar) e então veja qual algoritmo você precisa para o problema em questão e então comece a análise.
O que todos os tipos de projetos e algoritmos devo aprender:
Primeiro, escolha seu domínio. Meu domínio, por exemplo, era Finanças e marketing. Então eu posso falar sobre isso aqui. Embora a lista seja interminável, vou apenas escrever os algoritmos mais importantes que aprendi aqui
Marketing : Modelagem de séries temporais (principalmente modelagem ARIMA) para prever vendas, volume e valor futuros. A modelagem de séries temporais significa que você tem dados para uma coisa, digamos, dados de vendas para uma empresa por um período de tempo (pode ser meses, anos, dias etc.) e você prevê vendas para a empresa nos próximos anos/meses/dias.
Agrupar algoritmos para agrupar grupos-alvo e criar categorias separadas para cada grupo.
Modelagem de rotatividade para decidir quantos funcionários de campo ficarão e quantos sairão para gerenciar o fluxo de trabalho.
Finanças: Algos de classificação como Regressão Logística (Regressão Logística e regressão linear ou múltipla são completamente diferentes, apenas o nome é semelhante), SVN, Naive Bayes, XGBoost etc. para análise de Risco de Crédito para descobrir quem será inadimplente.
Regressão para avaliação de ativos (valor do estoque, ativo para hipoteca etc.)
f) Implementação
Como implementar seu conhecimento:
- Projetos em cursos de Coursera, Udemy etc
- Hackathons de Analytics Vidhya, Kaggle etc para ver onde você está entre as multidões.
- Projetos ao vivo
- Na empresa e no trabalho
Espero que isto ajude!
fonte: towardsdatascience.com


